



08.07.2026
Pinterest / electrichumanLA
Текст: Акбота Ибрагимова
404 Not Found: почему в интернете ничто не вечно
Что такое "гниение ссылок" и кто на самом деле отвечает за цифровую память
В сети давно живет фраза: “Все, что попало в интернет, остается там навсегда”. Она звучит убедительно, особенно когда речь идет о старых фотографиях, вирусных видео или неудачных постах, которые спустя годы снова всплывают в соцсетях.
Но реальность оказалась совсем другой. Исследование Pew Research Center показывает: интернет не только хранит информацию, но и постоянно ее теряет. Исчезают новости, научные статьи, государственные документы, архивы сайтов и даже целые цифровые эпохи.
Каждая четвертая страница уже исчезла
Pinterest / luigilocked
Мы привыкли воспринимать интернет как бесконечный архив знаний. Кажется, что любую информацию можно найти спустя годы. Но статистика говорит об обратном. По данным Pew Research Center, сегодня недоступна примерно каждая четвертая веб-страница, существовавшая в период с 2013 по 2023 год. Среди самых старых материалов ситуация еще хуже: почти 40% страниц, опубликованных около 30 лет назад, уже исчезли.
Проблема касается практически всех сфер. Каждая пятая ссылка в новостных публикациях больше не работает. Более половины источников, на которые ссылается Википедия, ведут в никуда. Даже юридические документы постепенно теряют свои доказательства: около половины ссылок в решениях Верховного суда США больше не открываются, а в профильных юридических журналах доля таких ссылок превышает 70%.
Исчезают научные публикации, государственные отчеты и журналистские расследования. Иногда не остается даже архивной копии.
“Гниющие” ссылки
У этого явления есть собственное название – link rot, или “гниение ссылок”. Наверняка это происходило и с вами: открываете старую статью, переходите по ссылке – и вместо нужного материала появляется ошибка 404 Not Found. Причины могут быть разными. Сайт сменил адрес, владелец перестал оплачивать домен, компания закрылась или просто решила удалить старые материалы. Для пользователя итог один – информация исчезает так, словно ее никогда не существовало.
Но проблема выходит далеко за пределы нескольких неработающих ссылок. В мире опубликованы миллионы научных исследований, однако значительная часть из них либо никогда не была надежно заархивирована, либо уже стала недоступной. А ведь современная наука строится именно на возможности проверить источник. Если ссылка исчезает, проверить выводы автора становится невозможно.
Интернет забывает почти как человек
Pinterest / leeuhhhhm
Даже если сама информация сохраняется, со временем меняется ее смысл. Мемы, фотографии и цитаты продолжают жить отдельно от своих первоисточников. Их начинают использовать в новом контексте, меняют подписи, вырывают из первоначальной истории. В итоге до аудитории доходит уже совсем другой смысл. Иногда забывание происходит сознательно.
Во многих странах люди могут потребовать удалить устаревшую или наносящую вред личную информацию из поисковой выдачи. В этом интернет неожиданно становится похож на человеческую память. Наш мозг тоже не хранит воспоминания в неизменном виде. Он постоянно их переписывает, смягчает болезненные события и постепенно избавляется от того, что больше не кажется важным.
Парадокс в том, что люди все сильнее полагаются на интернет именно как на внешнюю память. Психологи называют это эффектом Google. Когда нужную информацию можно найти за несколько секунд, мозг перестает хранить ее самостоятельно. Вместо фактов мы запоминаем, где именно их можно найти.
Это не делает человека менее умным. Просто меняется способ работы памяти. Мы меньше запоминаем и больше ищем. Проблема в том, что сама цифровая память оказывается куда менее надежной, чем нам казалось. Если источник исчезает, исчезает и часть знаний, которые мы доверили интернету.
Кто вообще отвечает за цифровую память
Pixabay / StockSnap
Во времена бумажных книг все было относительно понятно. За сохранность знаний отвечали библиотеки и архивы. С интернетом эта система перестала работать. Кто должен хранить цифровые материалы спустя десятилетия, издательства, университеты, библиотеки или сами авторы, платформ до сих пор никто не определил. В результате ответственность оказалась распределена между всеми, а значит, фактически не лежит ни на ком.
Решение о том, какие материалы останутся доступными, все чаще принимают не архивисты, а алгоритмы и частные компании. Одним из самых известных примеров стал сервис GeoCities. В 2009 году Yahoo закрыла платформу, и вместе с ней исчезли миллионы личных страниц, блогов и форумов 1990-х годов. Волонтеры успели спасти лишь небольшую часть этого цифрового наследия.
Сегодня похожая ситуация происходит с TikTok и Instagram. Видео могут исчезнуть за считаные минуты из-за авторских прав или правил платформы, даже если они уже стали частью интернет-культуры.
Интернет постепенно тонет в цифровом шуме
Pixabay / ludi
Есть и другая проблема. Все больше сайтов создаются не для людей, а для поисковых алгоритмов. Еще в 2023 году аналитики NewsGuard обнаружили сотни ресурсов, ежедневно публикующих огромные объемы текстов, полностью написанных искусственным интеллектом. Такие сайты существуют исключительно ради рекламных доходов. Ведь чем больше страниц, тем больше показов рекламы.
Институт Reuters по изучению журналистики предупреждает: подобный контент превращает интернет в цифровой шум. Профессиональная журналистика и качественные исследования постепенно теряются среди тысяч автоматически созданных материалов. Большинство таких сайтов живут лишь до тех пор, пока приносят прибыль. Как только трафик заканчивается, домен закрывают, а тысячи опубликованных материалов исчезают вместе с ним.
Люди все еще пытаются сохранить интернет
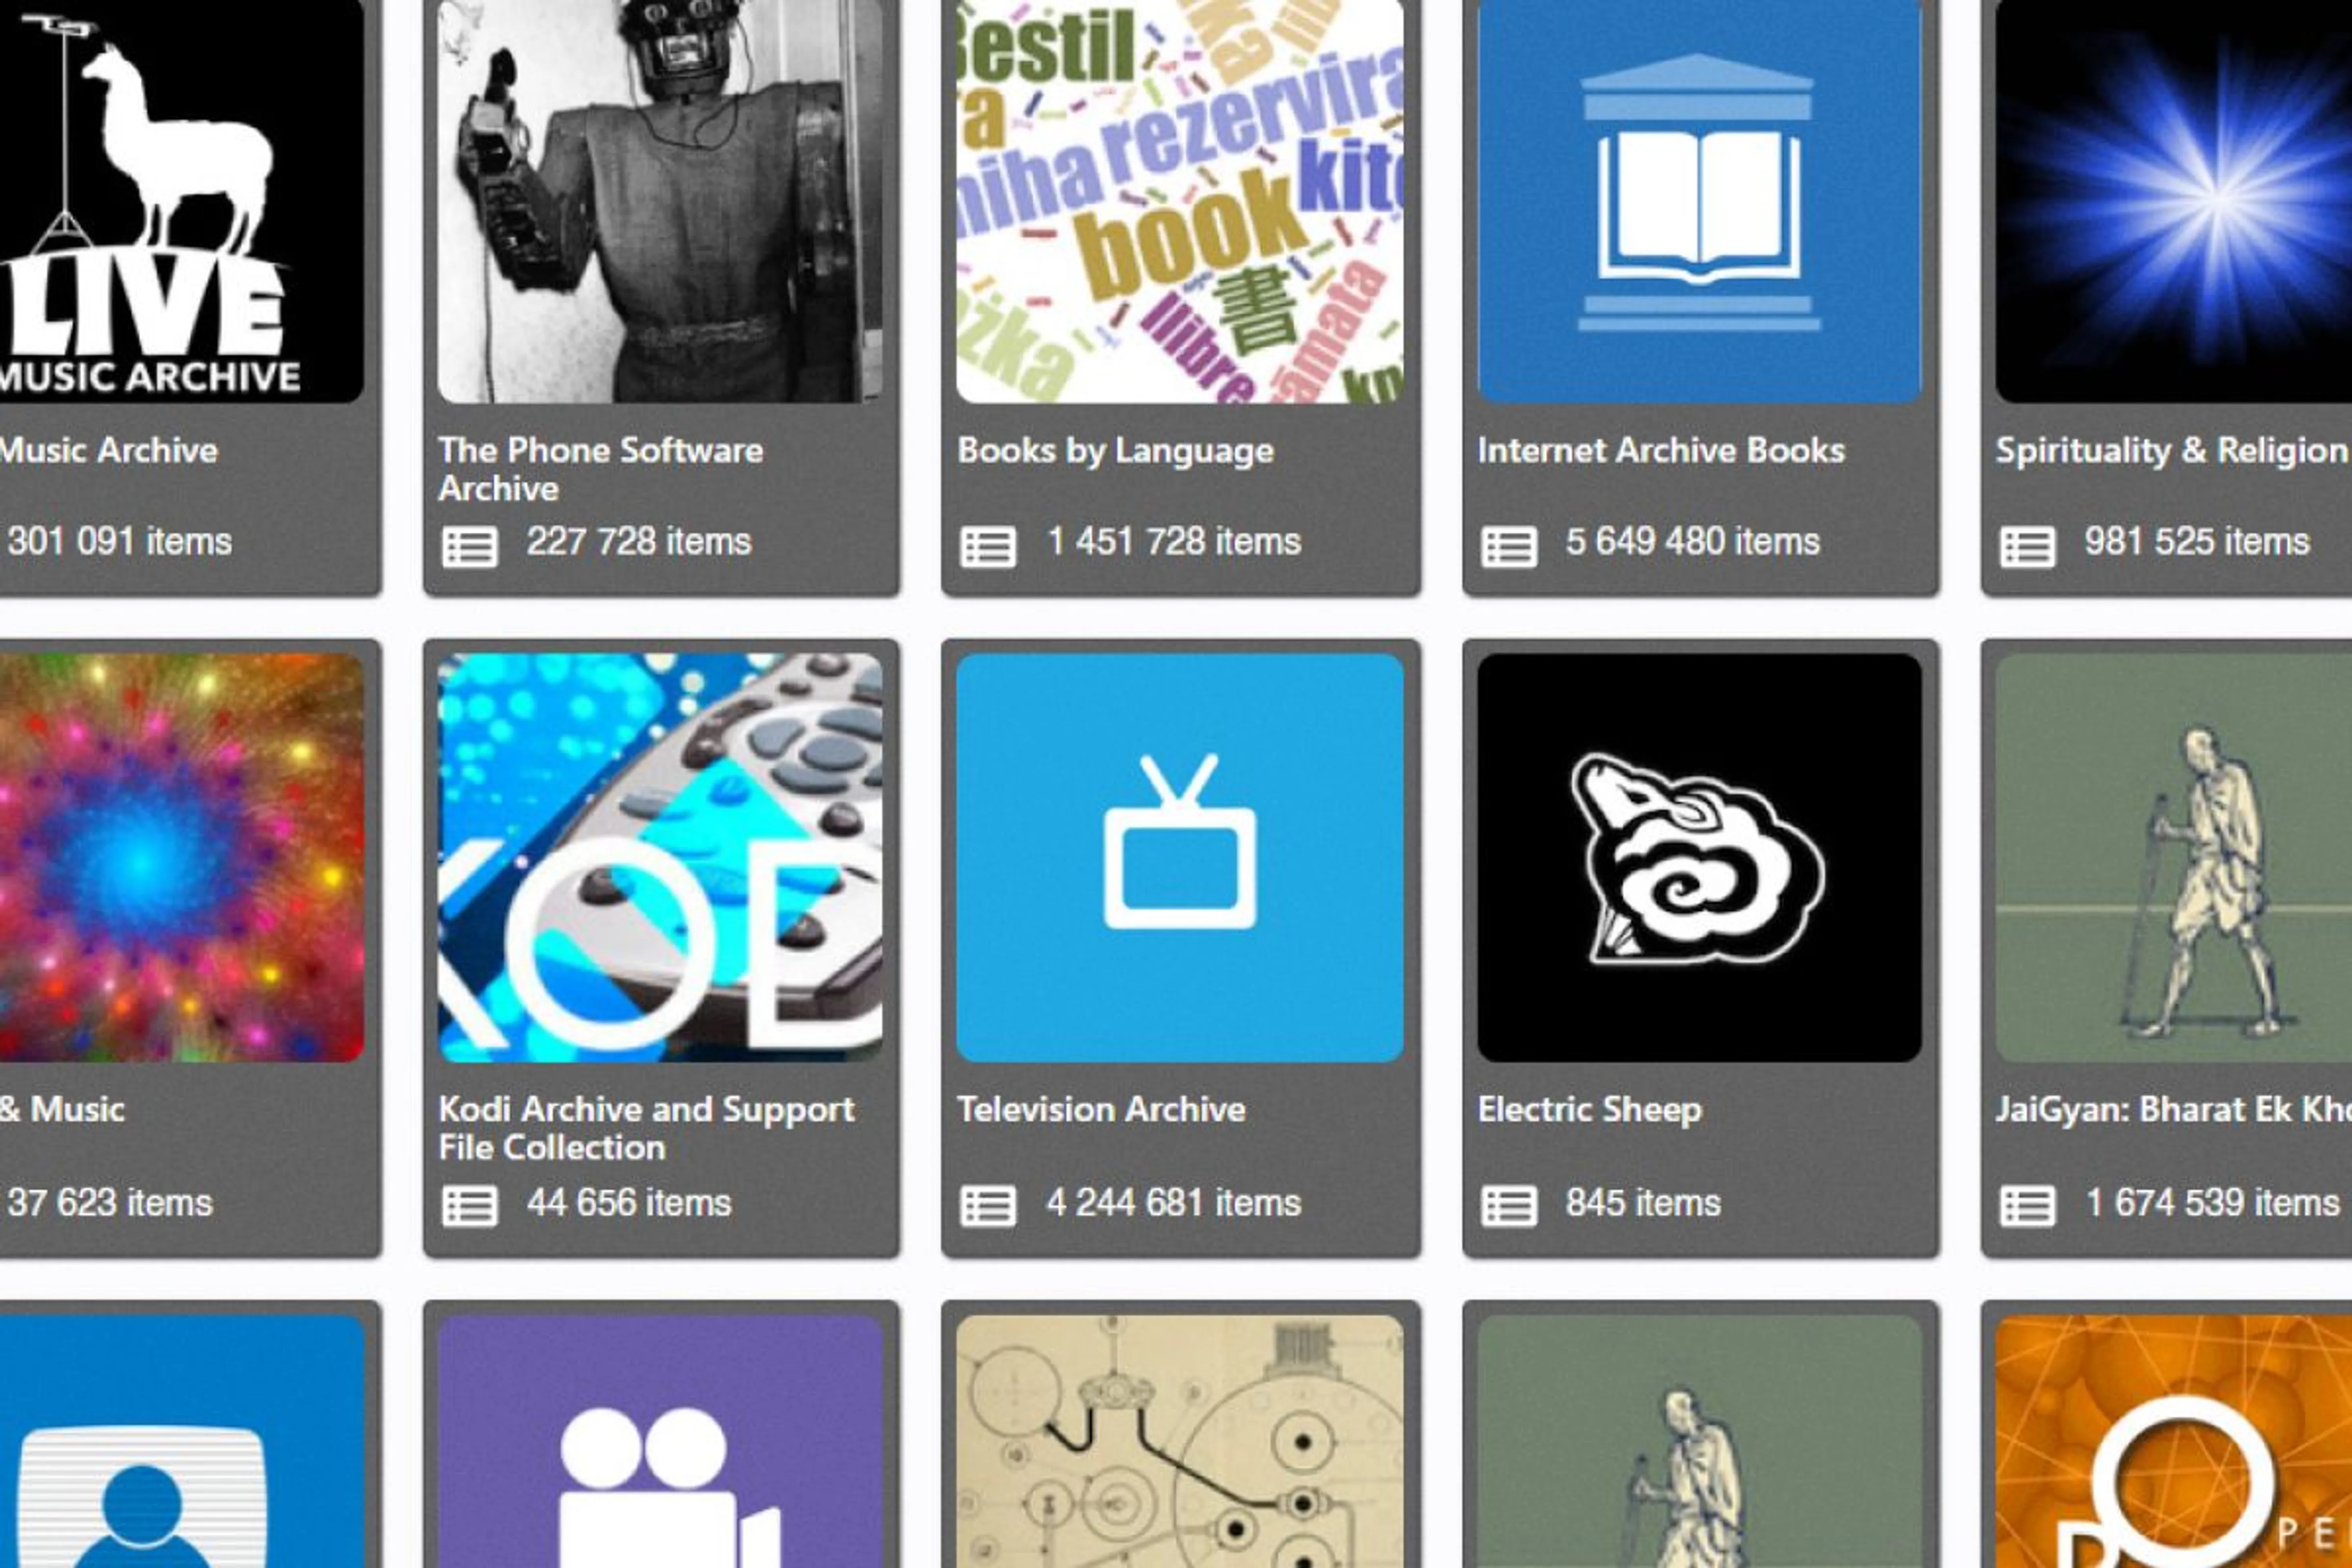
Несмотря на это, энтузиасты продолжают создавать цифровую память человечества. Самый известный проект – Internet Archive. Его основали в 1996 году с простой идеей: обеспечить свободный доступ ко всем знаниям. Осенью 2025 года архив преодолел символическую отметку в 1 трлн сохраненных веб-страниц. Именно здесь работает знаменитая Wayback Machine, позволяющая посмотреть, как выглядел любой сайт много лет назад. Архив ежедневно сохраняет около 150 ТБ данных, а вся система построена по принципу LOCKSS – Lots of Copies Keep Stuff Safe. Чем больше независимых копий существует, тем выше шанс, что информация переживет технические сбои, катастрофы или даже хакерские атаки.
Эта модель доказала свою эффективность и после масштабной атаки на Internet Archive в 2024 году. Несмотря на взлом пользовательской базы и DDoS-атаку, сами архивные данные удалось сохранить.
Можно ли сохранить цифровую память
Pinterest / qjselle
Пока единой мировой системы хранения интернета так и не существует. ЮНЕСКО давно предупреждает, что цифровое наследие нуждается в такой же защите, как книги, фильмы или произведения искусства. Однако авторское право зачастую мешает библиотекам свободно создавать архивные копии сайтов и документов.
Некоторые государства уже начали строить собственные цифровые архивы. Великобритания обязала крупные интернет-ресурсы передавать материалы национальным библиотекам. Германия и Австралия развивают государственные веб-архивы. В США действует закон OPEN Government Data Act, который требует публиковать государственные данные в машиночитаемом формате.
